Mise à jour du 4 septembre 2026 : OpenAI a publié GPT-6 Astra. Ce qui arrive dans votre abonnement ChatGPT et ce que cela coûte : GPT-6 Astra : disponibilité et prix.
Anthropic a publié Claude Fable 5.1 le 1er septembre 2026. Dans les tests publiés, le modèle résout nettement plus de tâches que son prédécesseur Fable 5, que le moins cher Opus 5 et que GPT-5.6 Sol d'OpenAI – surtout en recherche scientifique et en automatisation de processus d'entreprise. Les prix par token restent identiques, mais Fable 5.1 en consomme moins : selon Anthropic, les tâches typiques deviennent environ 25 % moins chères. Il y a pourtant un hic, absent de l'annonce : à partir du 14 septembre, les abonnés disposent au net d'environ 17 % de quota hebdomadaire en moins dans Claude Code qu'aujourd'hui – même si Anthropic présente le changement comme « 25 % d'utilisation en plus ». Le calcul est détaillé plus bas.
Sommaire
- Ce que signifient les pourcentages dans les benchmarks
- Les résultats des benchmarks en un coup d'œil
- Où Fable 5.1 est vraiment loin devant – et où il ne l'est pas
- Combien coûte Fable 5.1 – et pourquoi « même prix » revient quand même moins cher
- Quel modèle pour quelle tâche ? Trois recommandations
- Les petites lignes du quota : +25 % annoncés, −17 % en pratique
Ce que signifient les pourcentages dans les benchmarks
Un benchmark est un ensemble fixe d'épreuves que chaque modèle passe dans les mêmes conditions – comme un contrôle que plusieurs élèves rédigent. Le pourcentage indique combien de tâches le modèle a résolues. « Terminal-Bench 4.0 : 55,8 % » signifie donc : Fable 5.1 a accompli correctement 55,8 % de ces épreuves.
Trois repères aident à situer les chiffres :
- Aucun modèle n'atteint 100 %. Les épreuves sont volontairement si difficiles que même les meilleurs systèmes échouent. 55 % peut donc être un score de pointe – ce qui compte, c'est l'écart avec les autres modèles, pas le chiffre absolu.
- Chaque benchmark teste autre chose. Un modèle peut briller au test de programmation et faiblir au test scientifique, comme un élève excelle en maths et peine en anglais.
- Un chiffre du tableau n'est pas un pourcentage : GDPval-AA est un classement Elo comme aux échecs. Des évaluateurs comparent deux réponses et désignent un vainqueur ; il en résulte un score de classement. 1 853 contre 1 824 signifie : Fable 5.1 gagne ces duels un peu plus souvent qu'Opus 5.
Et une réserve valable pour toute annonce de modèle : les chiffres viennent du fabricant lui-même. Anthropic choisit quels tests figurent dans l'annonce – vraisemblablement ceux où son propre modèle brille. Les contre-tests indépendants paraissent généralement des jours, voire des semaines plus tard.
Les résultats des benchmarks en un coup d'œil
Tous les chiffres proviennent de l'annonce d'Anthropic du 1er septembre 2026. La meilleure valeur est en gras.
| Benchmark (ce qu'il teste) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (tâches de recherche scientifique) | 52,6 % | 24,7 % | 29,0 % | 22,4 % |
| Terminal-Bench 4.0 (travail autonome en ligne de commande) | 55,8 % | 42,0 % | 52,3 % | 37,3 % |
| AutomationBench (automatisation de processus d'entreprise) | 31,4 % | 17,1 % | 26,9 % | 19,6 % |
| GDPval-AA v2 (travail de bureau et de connaissance, classement Elo) | 1 853 | 1 723 | 1 824 | 1 711 |
| OSWorld 2.0 strict (utiliser un ordinateur comme un humain : fenêtres, clics) | 41,7 % | 36,1 % | 39,6 % | — |
| Humanity's Last Exam sans outils (savoir expert difficile, toutes disciplines) | 60,9 % | 57,8 % | 56,6 % | — |
| CursorBench 3.2.0 (programmation dans un éditeur de code) | 73,4 % | 70,5 % | 70,0 % | 67,2 % |
Où Fable 5.1 est vraiment loin devant – et où il ne l'est pas
Le tableau montre deux images très différentes selon l'endroit où l'on regarde.
Deux types de tâches font des bonds. En recherche scientifique (Terminal-Bench-Science), Fable 5.1 résout avec 52,6 % plus de deux fois plus d'épreuves que son propre prédécesseur – et laisse Opus 5 (29,0 %) et GPT-5.6 Sol (22,4 %) loin derrière. Même chose pour l'automatisation de processus (AutomationBench) : 31,4 % contre 17,1 % pour le prédécesseur. Ce sont précisément les tâches longues, en plusieurs étapes, où le modèle doit planifier seul, utiliser des outils et vérifier des résultats intermédiaires. Anthropic cite un exemple issu de la recherche : pour la conception de liants protéiques, Fable 5.1 a atteint un taux de réussite de près de 50 %, là où 10 à 15 % sont considérés comme habituels.
L'écart reste faible en programmation courante et en connaissances. Au test d'éditeur CursorBench, seuls 2,9 points de pourcentage séparent Fable 5.1 de son prédécesseur ; au test de connaissances Humanity's Last Exam, 3,1. Qui utilise le modèle pour des tâches normales de code et de texte remarquera à peine la différence au quotidien.
En bref : Fable 5.1 est avant tout un modèle pour les longues chaînes de travail autonomes – recherche, analyse, processus à nombreuses étapes. Pour la petite tâche rapide entre deux, l'avance est mince.
Combien coûte Fable 5.1 – et pourquoi « même prix » revient quand même moins cher
Les prix catalogue via l'interface pour développeurs (API) sont inchangés – l'économie se situe ailleurs :
| Poste (par million de tokens) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol* |
|---|---|---|---|---|
| Entrée | 10 $ | 10 $ | 5 $ | 4 $ |
| Sortie | 50 $ | 50 $ | 25 $ | 20 $ |
| Entrées mises en cache | 0,25 $ | 1,00 $ | — | — |
\* Prix promotionnel jusqu'au 21 novembre 2026 au moins ; prix catalogue 5 $/30 $.
Les tokens sont l'unité de facturation des fournisseurs d'IA – en gros, un fragment de mot. Et c'est là le vrai levier de prix : Fable 5.1 consomme moins de tokens pour le même travail. Anthropic chiffre l'économie à environ 25 % pour les tâches typiques et jusqu'à 45 % pour les longues chaînes de travail autonomes. Le fournisseur de données financières Bloomberg rapporte, d'après ses propres tests, que le modèle était environ deux fois plus rapide qu'Opus 5 avec moitié moins de tokens. S'y ajoute le prix du cache : qui renvoie plusieurs fois les mêmes documents – le cas normal des sessions de travail longues – ne paie plus qu'un quart du prix antérieur pour ces répétitions.
Quel modèle pour quelle tâche ? Trois recommandations
Prix et résultats de tests combinés donnent trois règles simples. Elles valent pour septembre 2026 et reposent sur les chiffres du fabricant cités plus haut :
- Tâches quotidiennes – textes, e-mails, traductions, programmation courante : le milieu de gamme suffit. Claude Sonnet 5 (2 $/10 $ par million de tokens) ou GPT-5.6 Sol (4 $/20 $) font ce travail pour une fraction du coût de Fable ; sur des tâches courtes et isolées, la différence de qualité est à peine perceptible. Qui travaille avec un abonnement Claude ménage en plus son quota hebdomadaire, car Fable y pèse doublement lourd (voir plus bas).
- Tâches isolées difficiles – bug épineux, analyse de contrat, évaluation complexe : Claude Opus 5 (5 $/25 $) est ici le point d'équilibre prix-performance. Il ne cède que quelques points à Fable 5.1 dans la plupart des tests, mais coûte moitié moins.
- Longues chaînes de travail autonomes – recherche sur de nombreuses sources, automatisation en plusieurs étapes, analyses scientifiques : c'est là que Fable 5.1 fait valoir son avance, et doublement : il résout nettement plus de ces tâches (52,6 % contre 29,0 % pour Opus 5 au test scientifique) et consomme moins de tokens pour y parvenir. Sur ce type de travail, le modèle le plus cher peut au final être le moins cher – mesuré au coût par tâche accomplie, pas par requête.
Les petites lignes du quota : +25 % annoncés, −17 % en pratique
Parallèlement à l'annonce du modèle, Anthropic a communiqué un changement des limites d'utilisation : à partir du 14 septembre 2026, les limites hebdomadaires standard de l'outil de programmation Claude Code augmentent durablement de 25 % – pour les offres Pro, Max, Team et les sièges Enterprise.
Ce que la communication omet : depuis mai court une augmentation temporaire de 50 %, prolongée plusieurs fois, qui expire le 13 septembre. Le calcul se présente donc ainsi :
| Quota hebdomadaire (base = 100) | |
|---|---|
| Limite d'origine | 100 |
| Aujourd'hui (temporaire +50 %) | 150 |
| À partir du 14 septembre (durable +25 % sur l'ancienne base) | 125 |
Par rapport à la limite d'origine, c'est effectivement 25 % de plus. Par rapport à ce dont les utilisateurs ont l'habitude depuis des mois, c'est environ 17 % de moins (125 au lieu de 150). Les deux affirmations sont vraies – l'annonce ne raconte que la première et tait la seconde. Des médias spécialisés comme BleepingComputer ont refait le calcul.
Pour les modèles Fable en abonnement, la règle reste inchangée : sur les sièges Max et premium, vous pouvez consacrer au maximum la moitié de votre limite hebdomadaire à Fable ; ensuite, il faut acheter du crédit supplémentaire ou passer à un modèle plus petit. Dans l'offre Pro, Fable fonctionne d'emblée sur crédits payants. Le fait que Fable 5.1 soit plus économe en tokens adoucit cela en pratique – mais ne change rien à la limite elle-même.
Si vous évaluez quels outils d'IA sont rentables pour votre entreprise : l'évolution des familles de modèles d'Anthropic et d'OpenAI est retracée dans nos articles sur GPT-5.6 Sol, Terra et Luna et l'histoire mouvementée de Claude Fable 5. Ce guide paraît sur office1.cloud, où les indépendants gèrent aussi factures et comptabilité.
Gerer les factures plus simplement
Easy Invoice regroupe devis, factures et gestion client dans le cloud.
Essayer Easy InvoiceLire ensuite
 Actualités du monde
Logiciel de gestion pour clubs de football : site, application et calendrier pour 39,99 € par mois
Le calendrier arrive tout seul, les résultats aussi, les parents préviennent depuis leur téléphone et le tournoi du club a son inscription en ligne : ce que le logiciel ligantor enlève à un club de football semaine après semaine – et ce qu'il coûte.
 Actualités du monde
Gagner de l'argent sur Twitch en 2026 : la monétisation est désormais ouverte à tous – et ce que ça change côté impôts
Twitch rend la monétisation accessible à tous en 2026 et abaisse les seuils Affiliate. Ce que ça veut dire pour toi – et quand un hobby devient un revenu d'appoint imposable.
 Actualités du monde
Coupe du monde 2026 : la phase à élimination directe est lancée – des huitièmes de poids
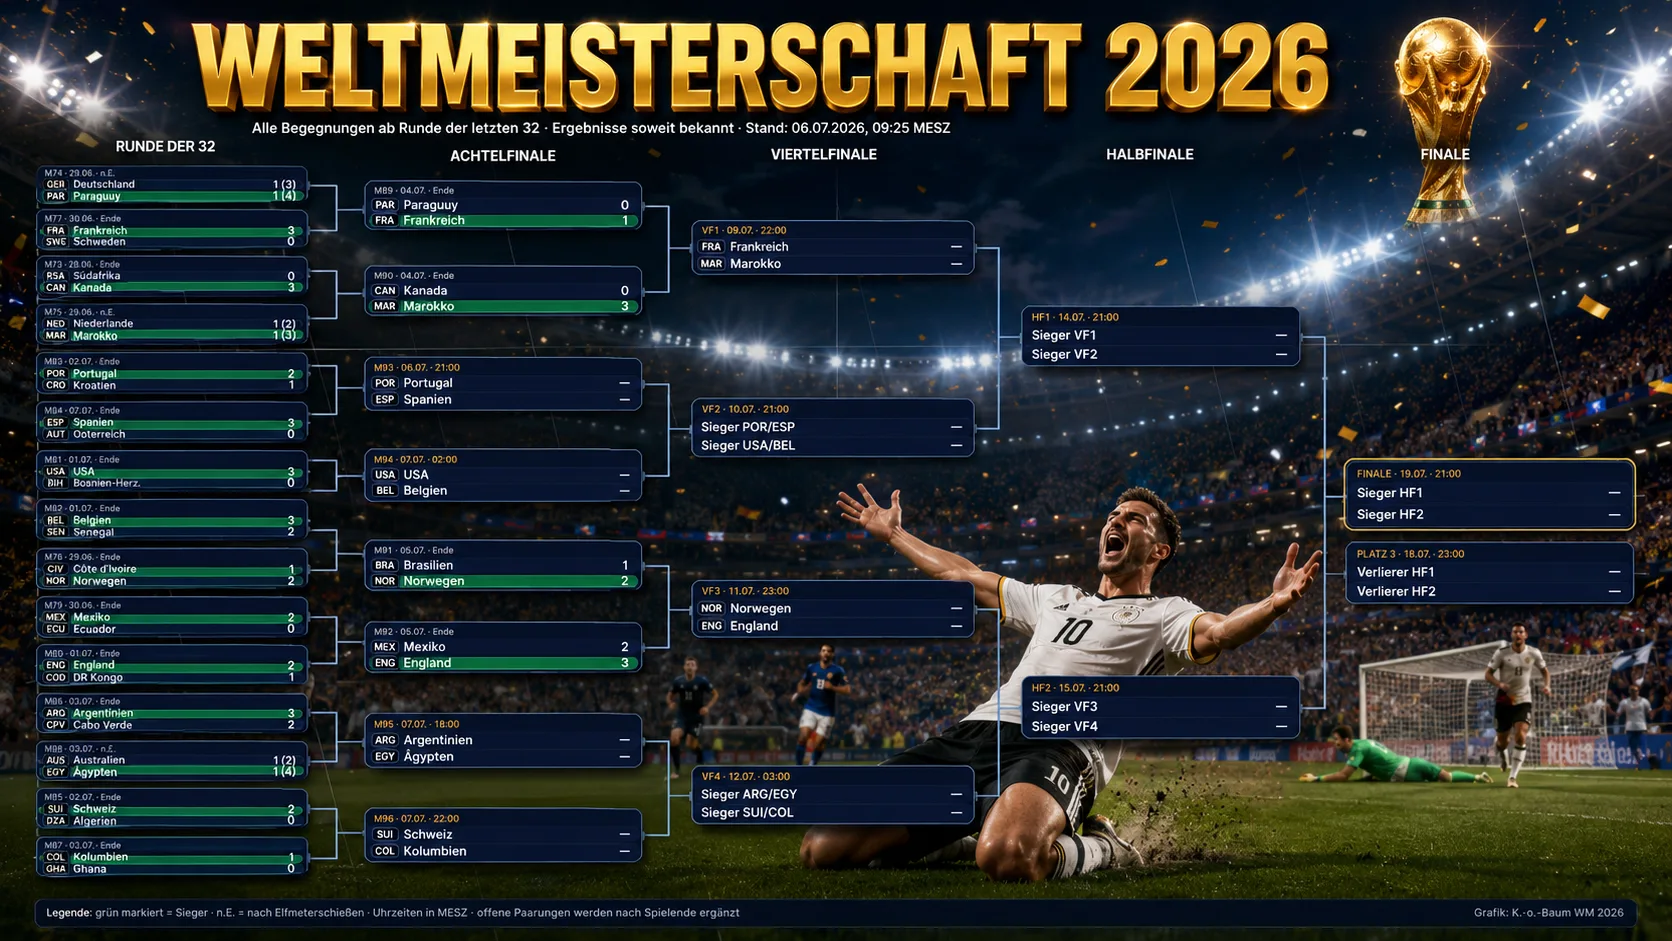
La Coupe du monde 2026 a laissé la phase de groupes derrière elle et est entrée dans la phase à élimination directe. Beaucoup de nouveautés : 48 équipes, un tour supplémentaire des 32es, des horaires inhabituels venus d'Amérique du Nord. Tour d'horizon du format, de la situation et des chocs des huitièmes.