Actualización del 4 de septiembre de 2026: OpenAI ha publicado GPT-6 Astra. Qué llega a su suscripción de ChatGPT y qué cuesta: GPT-6 Astra: disponibilidad y precios.
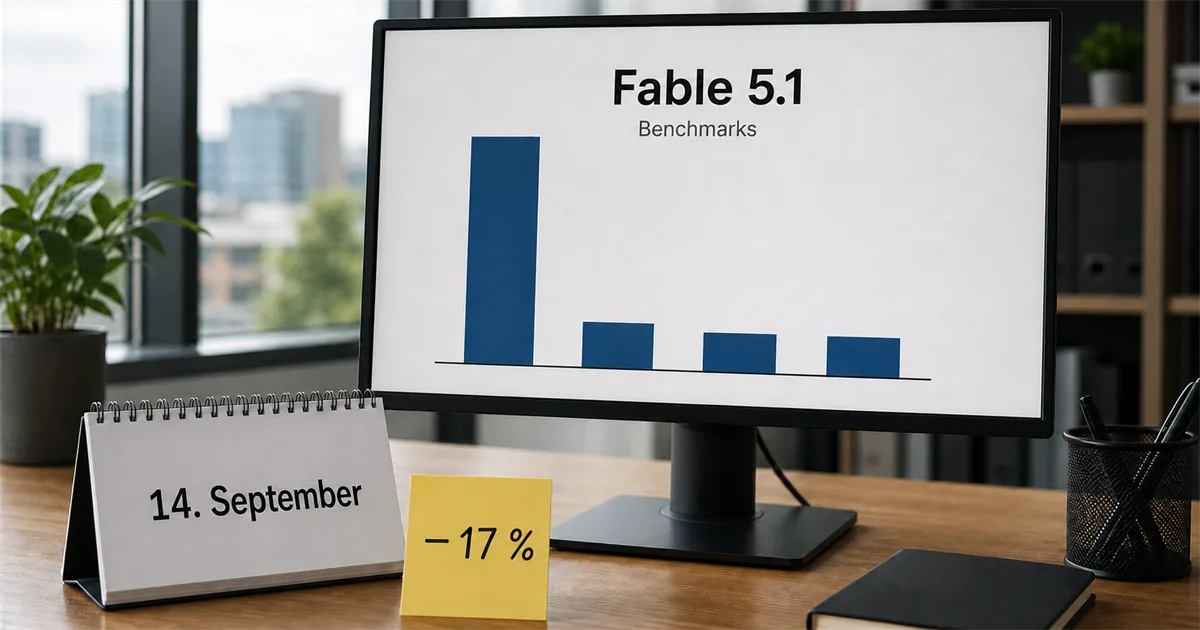
Anthropic publicó Claude Fable 5.1 el 1 de septiembre de 2026. En las pruebas publicadas, el modelo resuelve bastantes más tareas que su predecesor Fable 5, que el más barato Opus 5 y que GPT-5.6 Sol de OpenAI – sobre todo en investigación científica y en la automatización de procesos empresariales. Los precios por token no cambian, pero Fable 5.1 consume menos: según Anthropic, las tareas típicas salen alrededor de un 25 por ciento más baratas. Aun así hay una pega, y no figura en el anuncio: desde el 14 de septiembre, los suscriptores tendrán en Claude Code en neto alrededor de un 17 por ciento menos de cupo semanal que hoy – aunque Anthropic presenta el cambio como «un 25 por ciento más de uso». El cálculo se explica más abajo.
Contenido
- Qué significan los porcentajes en los benchmarks
- Los resultados de los benchmarks de un vistazo
- Dónde Fable 5.1 va realmente muy por delante – y dónde no
- Cuánto cuesta Fable 5.1 – y por qué «mismo precio» sale igualmente más barato
- ¿Qué modelo para qué tarea? Tres recomendaciones
- La letra pequeña del cupo: +25% anunciado, −17% en la práctica
Qué significan los porcentajes en los benchmarks
Un benchmark es un conjunto fijo de ejercicios de examen que todos los modelos reciben en las mismas condiciones – como un examen que escriben varios alumnos. El porcentaje indica cuántos ejercicios resolvió el modelo. «Terminal-Bench 4.0: 55,8 %» significa, por tanto: Fable 5.1 completó correctamente el 55,8 por ciento de esos ejercicios.
Tres claves ayudan a situar las cifras:
- Ningún modelo llega al 100 por ciento. Los ejercicios son a propósito tan difíciles que incluso los mejores sistemas fallan. Un 55 por ciento puede ser, por tanto, una puntuación de élite – lo decisivo es la distancia con los demás modelos, no la cifra absoluta.
- Cada benchmark mide algo distinto. Un modelo puede ser fuerte en la prueba de programación y flojo en la científica, igual que un alumno brilla en matemáticas y sufre con el inglés.
- Una cifra de la tabla no es un porcentaje: GDPval-AA es una puntuación Elo como en el ajedrez. Los evaluadores comparan dos respuestas y eligen un ganador; de ahí sale una cifra de clasificación. 1.853 frente a 1.824 significa: Fable 5.1 gana esos duelos algo más a menudo que Opus 5.
Y una reserva que vale para todo anuncio de modelo: las cifras proceden del propio fabricante. Anthropic elige qué pruebas aparecen en el anuncio – previsiblemente aquellas en las que su modelo luce bien. Las repeticiones independientes suelen llegar días o semanas después.
Los resultados de los benchmarks de un vistazo
Todas las cifras proceden del anuncio de Anthropic del 1 de septiembre de 2026. El mejor valor va en negrita.
| Benchmark (qué mide) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (tareas de investigación científica) | 52,6 % | 24,7 % | 29,0 % | 22,4 % |
| Terminal-Bench 4.0 (trabajo autónomo en la línea de comandos) | 55,8 % | 42,0 % | 52,3 % | 37,3 % |
| AutomationBench (automatización de procesos empresariales) | 31,4 % | 17,1 % | 26,9 % | 19,6 % |
| GDPval-AA v2 (trabajo de oficina y de conocimiento, puntuación Elo) | 1.853 | 1.723 | 1.824 | 1.711 |
| OSWorld 2.0 strict (manejar un ordenador como un humano: ventanas, clics) | 41,7 % | 36,1 % | 39,6 % | — |
| Humanity's Last Exam sin herramientas (conocimiento experto difícil de todas las áreas) | 60,9 % | 57,8 % | 56,6 % | — |
| CursorBench 3.2.0 (programar en un editor de código) | 73,4 % | 70,5 % | 70,0 % | 67,2 % |
Dónde Fable 5.1 va realmente muy por delante – y dónde no
La tabla muestra dos imágenes muy distintas según dónde se mire.
Hay grandes saltos en dos tipos de tarea. En tareas de investigación científica (Terminal-Bench-Science), Fable 5.1 resuelve con un 52,6 por ciento más del doble de ejercicios que su propio predecesor – y deja muy atrás a Opus 5 (29,0 %) y GPT-5.6 Sol (22,4 %). Algo parecido en la automatización de procesos (AutomationBench): 31,4 por ciento frente al 17,1 por ciento del predecesor. Son exactamente las tareas largas y de varios pasos en las que el modelo debe planificar por su cuenta, usar herramientas y comprobar resultados intermedios. Anthropic cita un ejemplo de la investigación: al diseñar ligandos de proteínas, Fable 5.1 alcanzó una tasa de acierto de casi el 50 por ciento, donde lo habitual es entre el 10 y el 15 por ciento.
La distancia sigue siendo pequeña en la programación cotidiana y el conocimiento. En la prueba de editor CursorBench solo 2,9 puntos porcentuales separan a Fable 5.1 de su predecesor; en la prueba de conocimiento Humanity's Last Exam, 3,1. Quien use el modelo para tareas normales de código y texto apenas notará la diferencia en el día a día.
En resumen: Fable 5.1 es sobre todo un modelo para cadenas de trabajo largas y autónomas – investigación, análisis, procesos de muchos pasos. Para la tarea rápida y suelta, la ventaja es pequeña.
Cuánto cuesta Fable 5.1 – y por qué «mismo precio» sale igualmente más barato
Los precios de lista a través de la interfaz para desarrolladores (API) no cambian – el ahorro está en otra parte:
| Concepto (por 1 millón de tokens) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol* |
|---|---|---|---|---|
| Entrada | 10 $ | 10 $ | 5 $ | 4 $ |
| Salida | 50 $ | 50 $ | 25 $ | 20 $ |
| Entradas guardadas (caché) | 0,25 $ | 1,00 $ | — | — |
\* Precio promocional al menos hasta el 21 de noviembre de 2026; precio de lista 5 $/30 $.
Los tokens son la unidad de facturación de los proveedores de IA – a grandes rasgos, un fragmento de palabra. Y aquí está la verdadera palanca de precio: Fable 5.1 consume menos tokens para el mismo trabajo. Anthropic cifra el ahorro en torno al 25 por ciento en tareas típicas y hasta el 45 por ciento en cadenas de trabajo largas y autónomas. El proveedor de datos financieros Bloomberg informa, según sus propias pruebas, de que el modelo fue aproximadamente el doble de rápido que Opus 5 usando la mitad de tokens. A eso se suma el precio de la caché: quien envía varias veces los mismos documentos – el caso normal en sesiones de trabajo largas – paga por esas repeticiones solo una cuarta parte del precio anterior.
¿Qué modelo para qué tarea? Tres recomendaciones
De la combinación de precio y resultados de las pruebas salen tres reglas sencillas. Valen para septiembre de 2026 y se basan en las cifras del fabricante citadas arriba:
- Tareas cotidianas – textos, correos, traducciones, programación normal: aquí basta la gama media. Claude Sonnet 5 (2 $/10 $ por millón de tokens) o GPT-5.6 Sol (4 $/20 $) hacen este trabajo por una fracción del coste de Fable; en tareas cortas y sueltas la diferencia de calidad apenas se nota. Quien trabaje con una suscripción de Claude protege además su cupo semanal, porque allí Fable pesa el doble (ver abajo).
- Tareas sueltas exigentes – un error de programación enrevesado, el análisis de un contrato, una evaluación compleja: Claude Opus 5 (5 $/25 $) es aquí el punto óptimo de precio y rendimiento. En la mayoría de las pruebas queda solo unos puntos por detrás de Fable 5.1, pero cuesta la mitad.
- Cadenas de trabajo largas y autónomas – investigación en muchas fuentes, automatización de varios pasos, análisis científicos: aquí Fable 5.1 explota su ventaja, y por partida doble: resuelve bastantes más tareas de este tipo (52,6 % frente al 29,0 % de Opus 5 en la prueba científica) y necesita menos tokens para hacerlo. En este tipo de trabajo, el modelo más caro puede acabar siendo el más barato – medido en coste por tarea completada, no por petición.
La letra pequeña del cupo: +25% anunciado, −17% en la práctica
En paralelo al anuncio del modelo, Anthropic comunicó un cambio en los límites de uso: desde el 14 de septiembre de 2026, los límites semanales estándar de la herramienta de programación Claude Code suben de forma permanente un 25 por ciento – para los planes Pro, Max, Team y los puestos Enterprise.
Lo que falta en la comunicación: desde mayo rige un aumento temporal del 50 por ciento, prorrogado varias veces, que expira el 13 de septiembre. El cálculo queda así:
| Cupo semanal (base = 100) | |
|---|---|
| Límite original | 100 |
| Hoy (temporal +50 %) | 150 |
| Desde el 14 de septiembre (permanente +25 % sobre la base antigua) | 125 |
Respecto al límite original, es efectivamente un 25 por ciento más. Respecto a lo que los usuarios llevan meses acostumbrados, es alrededor de un 17 por ciento menos (125 en lugar de 150). Ambas afirmaciones son ciertas – solo que el anuncio cuenta la primera y calla la segunda. Medios especializados como BleepingComputer han rehecho el cálculo.
Para los modelos Fable en suscripción, la regla no cambia: en los puestos Max y premium puede gastar como máximo la mitad de su límite semanal en Fable; después toca comprar crédito extra o cambiar a un modelo más pequeño. En el plan Pro, Fable funciona desde el principio solo con créditos de pago. Que Fable 5.1 sea más ahorrador con los tokens lo suaviza en la práctica – pero no cambia nada en el límite en sí.
Si está valorando qué herramientas de IA compensan en su negocio: cómo han evolucionado las familias de modelos de Anthropic y OpenAI lo puede leer en nuestros artículos sobre GPT-5.6 Sol, Terra y Luna y la agitada historia de Claude Fable 5. Esta guía se publica en office1.cloud, donde los autónomos también gestionan facturas y contabilidad.
Gestiona facturas con mas facilidad
Easy Invoice combina presupuestos, facturas y gestion de clientes en la nube.
Probar Easy InvoiceLeer a continuacion
 Noticias del mundo
Software de gestión para clubes de fútbol: web, app y calendario por 39,99 € al mes
El calendario llega solo, los resultados también, los padres avisan desde el móvil y el torneo del club tiene inscripción online: lo que el software ligantor le quita de trabajo a un club de fútbol semana tras semana – y lo que cuesta.
 Noticias del mundo
Ganar dinero con Twitch en 2026: la monetización ya está abierta para todos, y lo que eso significa para tus impuestos
Twitch hace la monetización accesible para todos en 2026 y baja las barreras de Affiliate. Qué significa esto para ti y cuándo tu hobby se convierte en un ingreso extra que tributa.
 Noticias del mundo
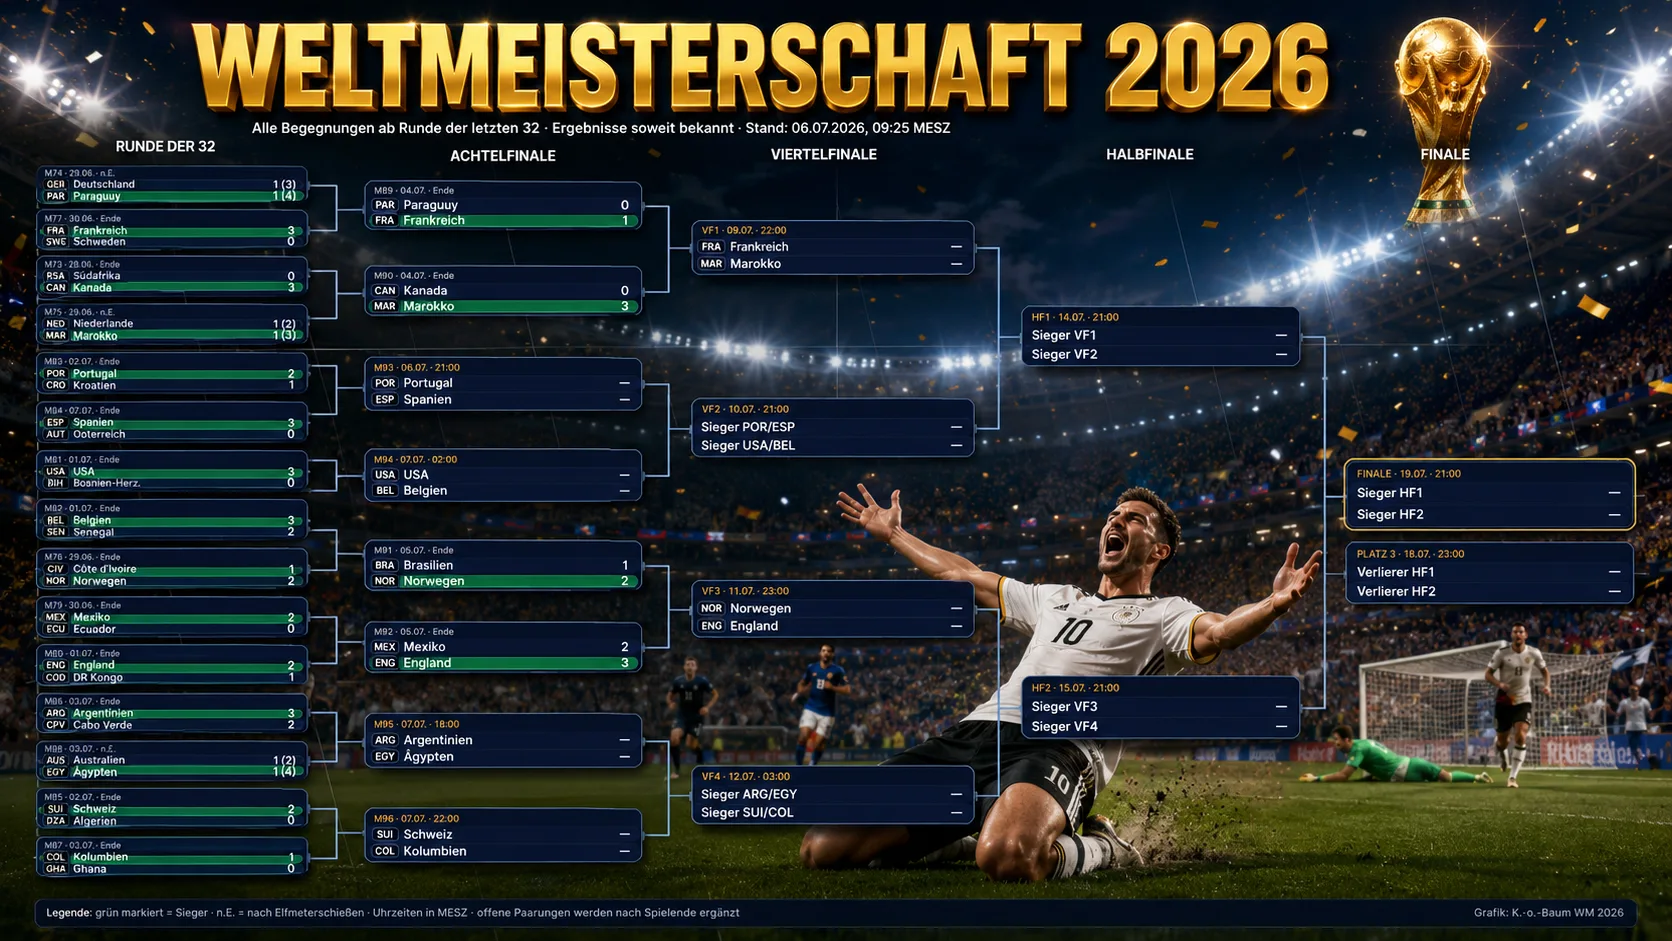
Mundial 2026: arranca la fase eliminatoria – octavos de final de altura
El Mundial 2026 ha dejado atrás la fase de grupos y ha entrado en la fase eliminatoria. Hay muchas novedades: 48 selecciones, una ronda adicional de dieciseisavos, horarios inusuales desde Norteamérica. Un repaso al formato, la situación y los partidazos de octavos.