4 Eylül 2026 güncellemesi: OpenAI, GPT-6 Astra’yı yayınladı. ChatGPT aboneliğinize ne geldiği ve ne tuttuğu GPT-6 Astra: erişim ve fiyatlar yazısında.
Anthropic, 1 Eylül 2026'da Claude Fable 5.1'i yayınladı. Yayımlanan testlerde model, selefi Fable 5'ten, daha ucuz olan Opus 5'ten ve OpenAI'nin GPT-5.6 Sol'undan belirgin şekilde daha fazla görevi çözüyor – özellikle bilimsel araştırmada ve iş süreçlerinin otomasyonunda. Token başına fiyatlar aynı kalıyor, ama Fable 5.1 daha az token tüketiyor: Anthropic'e göre tipik görevler yaklaşık yüzde 25 daha ucuz hale geliyor. Yine de bir pürüz var ve duyuruda yer almıyor: 14 Eylül'den itibaren aboneler, Claude Code'da bugüne kıyasla net olarak yaklaşık yüzde 17 daha az haftalık kotaya sahip olacak – Anthropic değişikliği „yüzde 25 daha fazla kullanım" olarak sunsa da. Bu hesabın nasıl çıktığını aşağıda okuyabilirsiniz.
İçindekiler
- Benchmark'lardaki yüzdeler ne anlama geliyor
- Benchmark sonuçlarına genel bakış
- Fable 5.1 gerçekten nerede çok önde – nerede değil
- Fable 5.1 ne kadar tutuyor – ve „aynı fiyat" neden yine de daha ucuz
- Hangi görev için hangi model? Üç öneri
- Kotanın küçük yazıları: +%25 duyuruldu, pratikte −%17
Benchmark'lardaki yüzdeler ne anlama geliyor
Benchmark, her modelin aynı koşullarda aldığı sabit bir sınav görevleri koleksiyonudur – birkaç öğrencinin yazdığı bir sınav gibi. Yüzde, modelin kaç görevi çözdüğünü söyler. „Terminal-Bench 4.0: %55,8" şu demektir: Fable 5.1 bu test görevlerinin yüzde 55,8'ini doğru tamamladı.
Sayıları yorumlarken üç şey yardımcı olur:
- Hiçbir model yüzde 100'e ulaşmaz. Görevler kasıtlı olarak o kadar zordur ki en iyi sistemler bile başarısız olur. Bu yüzden yüzde 55 zirve bir değer olabilir – belirleyici olan diğer modellere olan fark, mutlak sayı değildir.
- Her benchmark farklı bir şeyi ölçer. Bir model programlama testinde güçlü, bilim testinde zayıf olabilir; tıpkı bir öğrencinin matematikte parlayıp İngilizcede zorlanması gibi.
- Tablodaki bir sayı yüzde değildir: GDPval-AA, satrançtaki gibi bir Elo puanıdır. Değerlendiriciler iki yanıtı karşılaştırıp bir kazanan seçer; bundan bir sıralama sayısı doğar. 1.853'e karşı 1.824 şu demektir: Fable 5.1 bu düelloları Opus 5'ten biraz daha sık kazanıyor.
Ve her model duyurusu için geçerli bir çekince: Sayılar üreticinin kendisinden geliyor. Anthropic duyuruda hangi testlerin yer alacağını kendisi seçiyor – muhtemelen kendi modelinin iyi göründüğü testleri. Bağımsız doğrulama testleri genellikle günler, hatta haftalar sonra yayımlanır.
Benchmark sonuçlarına genel bakış
Tüm sayılar Anthropic'in 1 Eylül 2026 tarihli duyurusundan alınmıştır. En iyi değer kalın yazılmıştır.
| Benchmark (neyi ölçüyor) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (bilimsel araştırma görevleri) | %52,6 | %24,7 | %29,0 | %22,4 |
| Terminal-Bench 4.0 (komut satırında bağımsız çalışma) | %55,8 | %42,0 | %52,3 | %37,3 |
| AutomationBench (iş süreçlerinin otomasyonu) | %31,4 | %17,1 | %26,9 | %19,6 |
| GDPval-AA v2 (ofis ve bilgi işi, Elo puanı) | 1.853 | 1.723 | 1.824 | 1.711 |
| OSWorld 2.0 strict (bilgisayarı insan gibi kullanma: pencereler, tıklamalar) | %41,7 | %36,1 | %39,6 | — |
| Humanity's Last Exam araçsız (tüm alanlardan zor uzmanlık bilgisi) | %60,9 | %57,8 | %56,6 | — |
| CursorBench 3.2.0 (kod editöründe programlama) | %73,4 | %70,5 | %70,0 | %67,2 |
Fable 5.1 gerçekten nerede çok önde – nerede değil
Tablo, nereye baktığınıza göre iki çok farklı resim gösteriyor.
Büyük sıçramalar iki görev türünde. Bilimsel araştırma görevlerinde (Terminal-Bench-Science) Fable 5.1, yüzde 52,6 ile kendi selefinin iki katından fazla görevi çözüyor – Opus 5'i (%29,0) ve GPT-5.6 Sol'u (%22,4) çok geride bırakıyor. İş süreçlerinin otomasyonunda (AutomationBench) benzer: selefin yüzde 17,1'ine karşı yüzde 31,4. Bunlar tam da modelin kendi başına plan yapması, araçlar kullanması ve ara sonuçları kontrol etmesi gereken uzun, çok adımlı görevler. Anthropic araştırmadan bir örnek veriyor: Protein bağlayıcı tasarımında Fable 5.1, yüzde 10-15'in olağan sayıldığı yerde yaklaşık yüzde 50 isabet oranına ulaştı.
Günlük programlama ve bilgide fark küçük kalıyor. Editör testi CursorBench'te Fable 5.1 ile selefi arasında yalnızca 2,9 puan var; bilgi testi Humanity's Last Exam'de 3,1. Modeli normal kod ve metin görevleri için kullananlar günlük işte farkı zar zor hisseder.
Kısacası: Fable 5.1 her şeyden önce uzun, bağımsız iş zincirleri için bir model – araştırma, analiz, çok adımlı süreçler. Aradaki hızlı tekil görev için avantaj küçük.
Fable 5.1 ne kadar tutuyor – ve „aynı fiyat" neden yine de daha ucuz
Geliştirici arayüzü (API) üzerinden liste fiyatları değişmedi – tasarruf başka yerde:
| Kalem (1 milyon token başına) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol* |
|---|---|---|---|---|
| Girdi | 10 $ | 10 $ | 5 $ | 4 $ |
| Çıktı | 50 $ | 50 $ | 25 $ | 20 $ |
| Önbelleğe alınmış girdi (cache) | 0,25 $ | 1,00 $ | — | — |
\* En az 21 Kasım 2026'ya kadar kampanya fiyatı; liste fiyatı 5 $/30 $.
Token, yapay zekâ sağlayıcılarının faturalama birimidir – kabaca bir kelime parçası. Gerçek fiyat kaldıracı da burada: Fable 5.1 aynı iş için daha az token tüketiyor. Anthropic tasarrufu tipik görevlerde yaklaşık yüzde 25, uzun ve bağımsız iş zincirlerinde yüzde 45'e kadar olarak hesaplıyor. Finansal veri sağlayıcısı Bloomberg kendi testlerinden, modelin Opus 5'ten yaklaşık iki kat hızlı olduğunu ve yarısı kadar token kullandığını bildiriyor. Buna önbellek fiyatı ekleniyor: Aynı belgeleri tekrar tekrar gönderenler – uzun çalışma oturumlarında olağan durum – bu tekrarlar için artık önceki fiyatın yalnızca dörtte birini ödüyor.
Hangi görev için hangi model? Üç öneri
Fiyat ve test sonuçlarının birleşiminden üç basit kural çıkıyor. Eylül 2026 itibarıyla geçerlidir ve yukarıdaki üretici verilerine dayanır:
- Günlük görevler – metinler, e-postalar, çeviriler, normal programlama görevleri: Burada orta sınıf yeter. Claude Sonnet 5 (milyon token başına 2 $/10 $) veya GPT-5.6 Sol (4 $/20 $) bu işi Fable maliyetinin çok küçük bir kısmına yapar; kısa tekil görevlerde kalite farkı zar zor hissedilir. Claude aboneliğinde çalışanlar böylece haftalık kotalarını da korur, çünkü Fable orada iki kat ağır sayılır (aşağıya bakın).
- Zor tekil görevler – çetrefilli bir programlama hatası, sözleşme analizi, karmaşık bir değerlendirme: Claude Opus 5 (5 $/25 $) burada fiyat-performans noktasıdır. Çoğu testte Fable 5.1'in yalnızca birkaç puan gerisinde kalır ama yarı fiyatınadır.
- Uzun, bağımsız iş zincirleri – çok kaynaklı araştırma, çok adımlı otomasyon, bilimsel analizler: Fable 5.1 avantajını burada, hem de iki kez kullanır: Bu tür görevlerin belirgin şekilde daha fazlasını çözer (bilim testinde Opus 5'in %29,0'una karşı %52,6) ve bunun için daha az token harcar. Bu tür işlerde daha pahalı model, sonuçta daha ucuz olan çıkabilir – istek başına değil, tamamlanan görev başına maliyetle ölçüldüğünde.
Kotanın küçük yazıları: +%25 duyuruldu, pratikte −%17
Model duyurusuna paralel olarak Anthropic, kullanım limitlerinde bir değişiklik duyurdu: 14 Eylül 2026'dan itibaren programlama aracı Claude Code'daki standart haftalık limitler kalıcı olarak yüzde 25 artıyor – Pro, Max, Team ve Enterprise koltuk planları için.
Duyuruda eksik olan: Mayıs'tan beri geçici yüzde 50'lik bir artış yürürlükte; birkaç kez uzatıldı ve 13 Eylül'de sona eriyor. Hesap bu yüzden şöyle görünüyor:
| Haftalık kota (taban = 100) | |
|---|---|
| Orijinal limit | 100 |
| Bugün (geçici +%50) | 150 |
| 14 Eylül'den itibaren (eski tabana kalıcı +%25) | 125 |
Orijinal limite kıyasla bu gerçekten yüzde 25 daha fazla. Kullanıcıların aylardır alıştığı düzeye kıyasla ise yaklaşık yüzde 17 daha az (150 yerine 125). İki ifade de doğru – yalnızca duyuru birincisini anlatıyor, ikincisini söylemiyor. BleepingComputer gibi sektör medyası hesabı yeniden çıkardı.
Abonelikteki Fable modelleri için kural değişmedi: Max ve premium koltuklarda haftalık limitinizin en fazla yarısını Fable'a harcayabilirsiniz; sonrasında ek kredi satın alır ya da daha küçük bir modele geçersiniz. Pro planında Fable baştan itibaren yalnızca ücretli ek kredilerle çalışır. Fable 5.1'in token'larla daha tutumlu olması bunu pratikte biraz yumuşatır – limitin kendisinde hiçbir şey değiştirmez.
İşletmeniz için hangi yapay zekâ araçlarının karşılığını verdiğini hesaplıyorsanız: Anthropic ve OpenAI model ailelerinin nasıl geliştiğini GPT-5.6 Sol, Terra ve Luna ile Claude Fable 5'in inişli çıkışlı hikâyesi yazılarımızda okuyabilirsiniz. Bu rehber, serbest çalışanların fatura ve muhasebe işlerini de yürüttüğü office1.cloud sitesinde yayımlanıyor.
Faturalari daha kolay yonet
Easy Invoice teklifleri, faturalari ve musteri yonetimini bulutta birlestirir.
Easy Invoice u deneSonraki okuma
 Dünyadan haberler
Futbol kulüpleri için kulüp yönetim yazılımı: web sitesi, uygulama ve fikstür ayda 39,99 €
Fikstür kendiliğinden geliyor, sonuçlar da, veliler telefondan bildiriyor ve kulübün turnuvasında çevrimiçi kayıt var: ligantor yazılımı bir futbol kulübünün üzerinden hafta be hafta neyi alıyor – ve kaça mal oluyor.
 Dünyadan haberler
Twitch'te Para Kazanmak 2026: Para kazanma artık herkese açık – ve bunun vergisel anlamı ne?
Twitch 2026'da para kazanmayı herkese açtı ve Affiliate eşiklerini düşürdü. Bunun senin için anlamı ne – ve hobiden ne zaman vergiye tabi bir yan gelir doğuyor?
 Dünyadan haberler
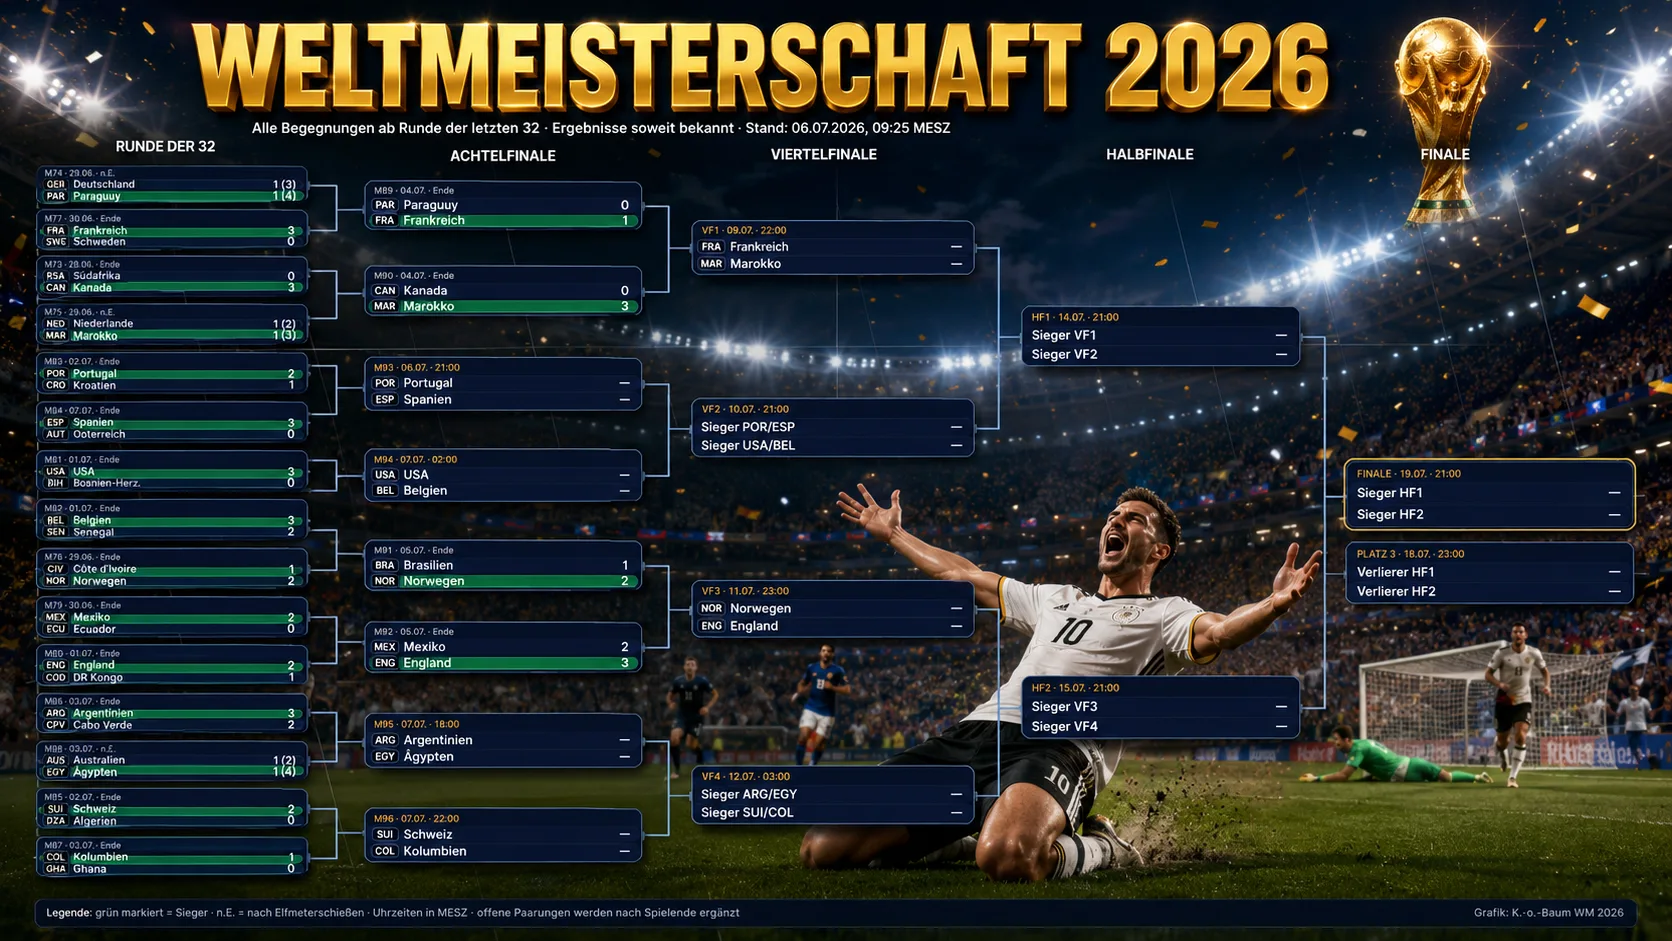
2026 Dünya Kupası: Eleme turu başladı – son 16'da dev randevular
2026 Dünya Kupası grup aşamasını geride bırakıp eleme turuna girdi. Yenilikler çok: 48 takım, ek bir son 32 turu, Kuzey Amerika kaynaklı alışılmadık başlama saatleri. Format, son durum ve son 16'nın dev maçlarına bir bakış.