Update 4 september 2026: OpenAI heeft GPT-6 Astra uitgebracht. Wat er in uw ChatGPT-abonnement aankomt en wat het kost, staat in GPT-6 Astra: beschikbaarheid en prijzen.
Anthropic heeft op 1 september 2026 Claude Fable 5.1 uitgebracht. In de gepubliceerde tests lost het model aanzienlijk meer taken op dan zijn voorganger Fable 5, dan het goedkopere Opus 5 en dan GPT-5.6 Sol van OpenAI – vooral bij wetenschappelijk onderzoek en het automatiseren van bedrijfsprocessen. De prijzen per token blijven gelijk, maar Fable 5.1 verbruikt er minder van: typische taken worden volgens Anthropic zo'n 25 procent goedkoper. Toch is er een addertje, en dat staat niet in de aankondiging: vanaf 14 september hebben abonnees in Claude Code per saldo zo'n 17 procent minder weektegoed dan vandaag – ook al verkoopt Anthropic de wijziging als „25 procent meer gebruik". Hoe die rekensom werkt, leest u verderop.
Inhoud
- Wat de percentages in benchmarks betekenen
- De benchmarkresultaten in één oogopslag
- Waar Fable 5.1 echt ver voorop ligt – en waar niet
- Wat kost Fable 5.1 – en waarom „dezelfde prijs" toch goedkoper is
- Welk model voor welke taak? Drie adviezen
- De kleine lettertjes bij het tegoed: +25% aangekondigd, −17% in de praktijk
Wat de percentages in benchmarks betekenen
Een benchmark is een vaste verzameling toetsopgaven die elk model onder dezelfde omstandigheden krijgt – zoals een proefwerk dat meerdere leerlingen maken. Het percentage zegt hoeveel opgaven het model heeft opgelost. „Terminal-Bench 4.0: 55,8%" betekent dus: Fable 5.1 heeft 55,8 procent van deze testopgaven correct afgerond.
Drie dingen helpen bij het duiden:
- Geen enkel model haalt 100 procent. De opgaven zijn met opzet zo moeilijk dat ook de beste systemen falen. 55 procent kan daarom een topscore zijn – bepalend is de afstand tot de andere modellen, niet het absolute getal.
- Elke benchmark toetst iets anders. Een model kan sterk zijn in de programmeertest en zwak in de wetenschapstest, zoals een leerling kan uitblinken in wiskunde en worstelen met Engels.
- Eén getal in de tabel is geen percentage: GDPval-AA is een Elo-waardering zoals bij schaken. Beoordelaars vergelijken twee antwoorden en wijzen een winnaar aan; daaruit ontstaat een ranggetal. 1.853 tegenover 1.824 betekent: Fable 5.1 wint zulke duels iets vaker dan Opus 5.
En één voorbehoud dat bij elke modelaankondiging geldt: de cijfers komen van de fabrikant zelf. Anthropic kiest welke tests in de aankondiging staan – aannemelijk die waarin het eigen model goed scoort. Onafhankelijke hertests verschijnen meestal pas dagen tot weken later.
De benchmarkresultaten in één oogopslag
Alle cijfers komen uit de aankondiging van Anthropic van 1 september 2026. De beste waarde is vetgedrukt.
| Benchmark (wat hij toetst) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (wetenschappelijke onderzoekstaken) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (zelfstandig werken op de opdrachtregel) | 55,8% | 42,0% | 52,3% | 37,3% |
| AutomationBench (automatiseren van bedrijfsprocessen) | 31,4% | 17,1% | 26,9% | 19,6% |
| GDPval-AA v2 (kantoor- en kenniswerk, Elo-waardering) | 1.853 | 1.723 | 1.824 | 1.711 |
| OSWorld 2.0 strict (een computer bedienen als een mens: vensters, klikken) | 41,7% | 36,1% | 39,6% | — |
| Humanity's Last Exam zonder hulpmiddelen (zware vakkennis uit alle vakgebieden) | 60,9% | 57,8% | 56,6% | — |
| CursorBench 3.2.0 (programmeren in een code-editor) | 73,4% | 70,5% | 70,0% | 67,2% |
Waar Fable 5.1 echt ver voorop ligt – en waar niet
De tabel laat twee heel verschillende beelden zien, afhankelijk van waar u kijkt.
Grote sprongen zitten in twee taaktypen. Bij wetenschappelijke onderzoekstaken (Terminal-Bench-Science) lost Fable 5.1 met 52,6 procent ruim twee keer zoveel opgaven op als zijn eigen voorganger – en laat het Opus 5 (29,0%) en GPT-5.6 Sol (22,4%) ver achter zich. Vergelijkbaar bij het automatiseren van bedrijfsprocessen (AutomationBench): 31,4 procent tegenover 17,1 procent bij de voorganger. Dit zijn precies de lange, meerstaps taken waarbij het model zelfstandig moet plannen, gereedschappen moet gebruiken en tussenresultaten moet controleren. Anthropic noemt een voorbeeld uit het onderzoek: bij het ontwerpen van eiwitbinders haalde Fable 5.1 een trefkans van bijna 50 procent, waar 10 tot 15 procent gebruikelijk geldt.
Klein blijft de afstand bij alledaags programmeren en feitenkennis. In de editortest CursorBench scheiden slechts 2,9 procentpunten Fable 5.1 van zijn voorganger, in de kennistest Humanity's Last Exam 3,1. Wie het model voor normale code- en teksttaken gebruikt, merkt het verschil in de praktijk nauwelijks.
Kortom: Fable 5.1 is vooral een model voor lange, zelfstandige werkketens – onderzoek, analyse, processen met veel stappen. Voor de snelle losse taak tussendoor is de voorsprong klein.
Wat kost Fable 5.1 – en waarom „dezelfde prijs" toch goedkoper is
De lijstprijzen via de interface voor ontwikkelaars (API) zijn ongewijzigd – de besparing zit ergens anders:
| Post (per 1 miljoen tokens) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol* |
|---|---|---|---|---|
| Invoer | $10 | $10 | $5 | $4 |
| Uitvoer | $50 | $50 | $25 | $20 |
| Tussentijds opgeslagen invoer (cache) | $0,25 | $1,00 | — | — |
\* Actieprijs tot ten minste 21 november 2026; lijstprijs $5/$30.
Tokens zijn de afrekeneenheid van AI-aanbieders – grofweg een woorddeel. En hier zit de echte prijshefboom: Fable 5.1 verbruikt minder tokens voor hetzelfde werk. Anthropic becijfert de besparing op circa 25 procent bij typische taken en tot 45 procent bij lange, zelfstandige werkketens. De financiële dataleverancier Bloomberg meldt uit eigen tests dat het model ongeveer twee keer zo snel was als Opus 5 en half zoveel tokens gebruikte. Daar komt de cacheprijs bij: wie dezelfde documenten herhaaldelijk meestuurt – het normale geval bij langere werksessies – betaalt voor die herhalingen nog maar een kwart van de eerdere prijs.
Welk model voor welke taak? Drie adviezen
Uit prijs en testresultaten samen volgen drie eenvoudige vuistregels. Ze gelden voor de stand van september 2026 en zijn gebaseerd op bovenstaande fabrikantcijfers:
- Dagelijkse taken – teksten, e-mails, vertalingen, normale programmeertaken: hier volstaat de middenklasse. Claude Sonnet 5 ($2/$10 per miljoen tokens) of GPT-5.6 Sol ($4/$20) doen dit werk voor een fractie van de Fable-kosten; bij korte losse taken is het kwaliteitsverschil nauwelijks merkbaar. Wie in een Claude-abonnement werkt, spaart daarmee ook zijn weektegoed, want Fable telt daar dubbel zwaar (zie hieronder).
- Zware losse taken – een lastige programmeerfout, contractanalyse, een complexe evaluatie: Claude Opus 5 ($5/$25) is hier het prijs-prestatiepunt. Het ligt in de meeste tests maar enkele punten achter Fable 5.1, maar kost de helft.
- Lange, zelfstandige werkketens – onderzoek over veel bronnen, meerstaps automatisering, wetenschappelijke analyses: hier speelt Fable 5.1 zijn voorsprong uit, en wel dubbel: het lost aanzienlijk meer van zulke taken op (52,6% tegen 29,0% bij Opus 5 in de wetenschapstest) en heeft er minder tokens voor nodig. Bij dit soort werk kan het duurdere model per saldo het goedkoopste zijn – gemeten naar kosten per afgeronde taak, niet per aanvraag.
De kleine lettertjes bij het tegoed: +25% aangekondigd, −17% in de praktijk
Naast de modelaankondiging heeft Anthropic een wijziging van de gebruikslimieten gecommuniceerd: vanaf 14 september 2026 stijgen de standaard weeklimieten in het programmeergereedschap Claude Code blijvend met 25 procent – voor de abonnementen Pro, Max, Team en Enterprise-seats.
Wat in de mededeling ontbreekt: sinds mei loopt een tijdelijke verhoging van 50 procent, meermaals verlengd, die op 13 september afloopt. De rekensom ziet er daarom zo uit:
| Weektegoed (basis = 100) | |
|---|---|
| Oorspronkelijke limiet | 100 |
| Vandaag (tijdelijk +50%) | 150 |
| Vanaf 14 september (blijvend +25% op de oude basis) | 125 |
Ten opzichte van de oorspronkelijke limiet is dat inderdaad 25 procent meer. Ten opzichte van wat gebruikers al maanden gewend zijn, is het circa 17 procent minder (125 in plaats van 150). Beide uitspraken kloppen – alleen vertelt de aankondiging de eerste en verzwijgt ze de tweede. Vakmedia zoals BleepingComputer hebben de berekening nagetrokken.
Voor Fable-modellen in abonnementen blijft de regel ongewijzigd: op Max- en premiumseats mag u hoogstens de helft van uw weeklimiet aan Fable besteden; daarna koopt u extra tegoed of schakelt u over op een kleiner model. In het Pro-abonnement draait Fable van meet af aan op betaald extra tegoed. Dat Fable 5.1 zuiniger met tokens omgaat, verzacht dit in de praktijk iets – aan de limiet zelf verandert het niets.
Als u uitzoekt welke AI-gereedschappen voor uw bedrijf lonen: hoe de modelfamilies van Anthropic en OpenAI zich hebben ontwikkeld, leest u in onze artikelen over GPT-5.6 Sol, Terra en Luna en de bewogen geschiedenis van Claude Fable 5. Deze gids verschijnt op office1.cloud, waar zelfstandigen ook facturen en boekhouding regelen.
Facturen eenvoudiger beheren
Easy Invoice combineert offertes, facturen en klantenbeheer in de cloud.
Easy Invoice proberenLees verder
 Nieuws uit de wereld
Verenigingssoftware voor voetbalclubs: website, app en speelschema voor € 39,99 per maand
Het speelschema komt vanzelf binnen, de uitslagen ook, ouders melden hun kind af via de telefoon en het eigen toernooi heeft een online inschrijving: wat de verenigingssoftware ligantor een voetbalclub week na week uit handen neemt – en wat het kost.
 Nieuws uit de wereld
Geld verdienen met Twitch in 2026: monetization staat nu voor iedereen open – en wat dat fiscaal betekent
Twitch maakt monetization in 2026 voor iedereen toegankelijk en verlaagt de Affiliate-drempels. Wat dat voor jou betekent – en wanneer je hobby een belastbaar bijverdienste wordt.
 Nieuws uit de wereld
WK 2026: De knock-outfase is begonnen – achtste finales met zwaargewichten
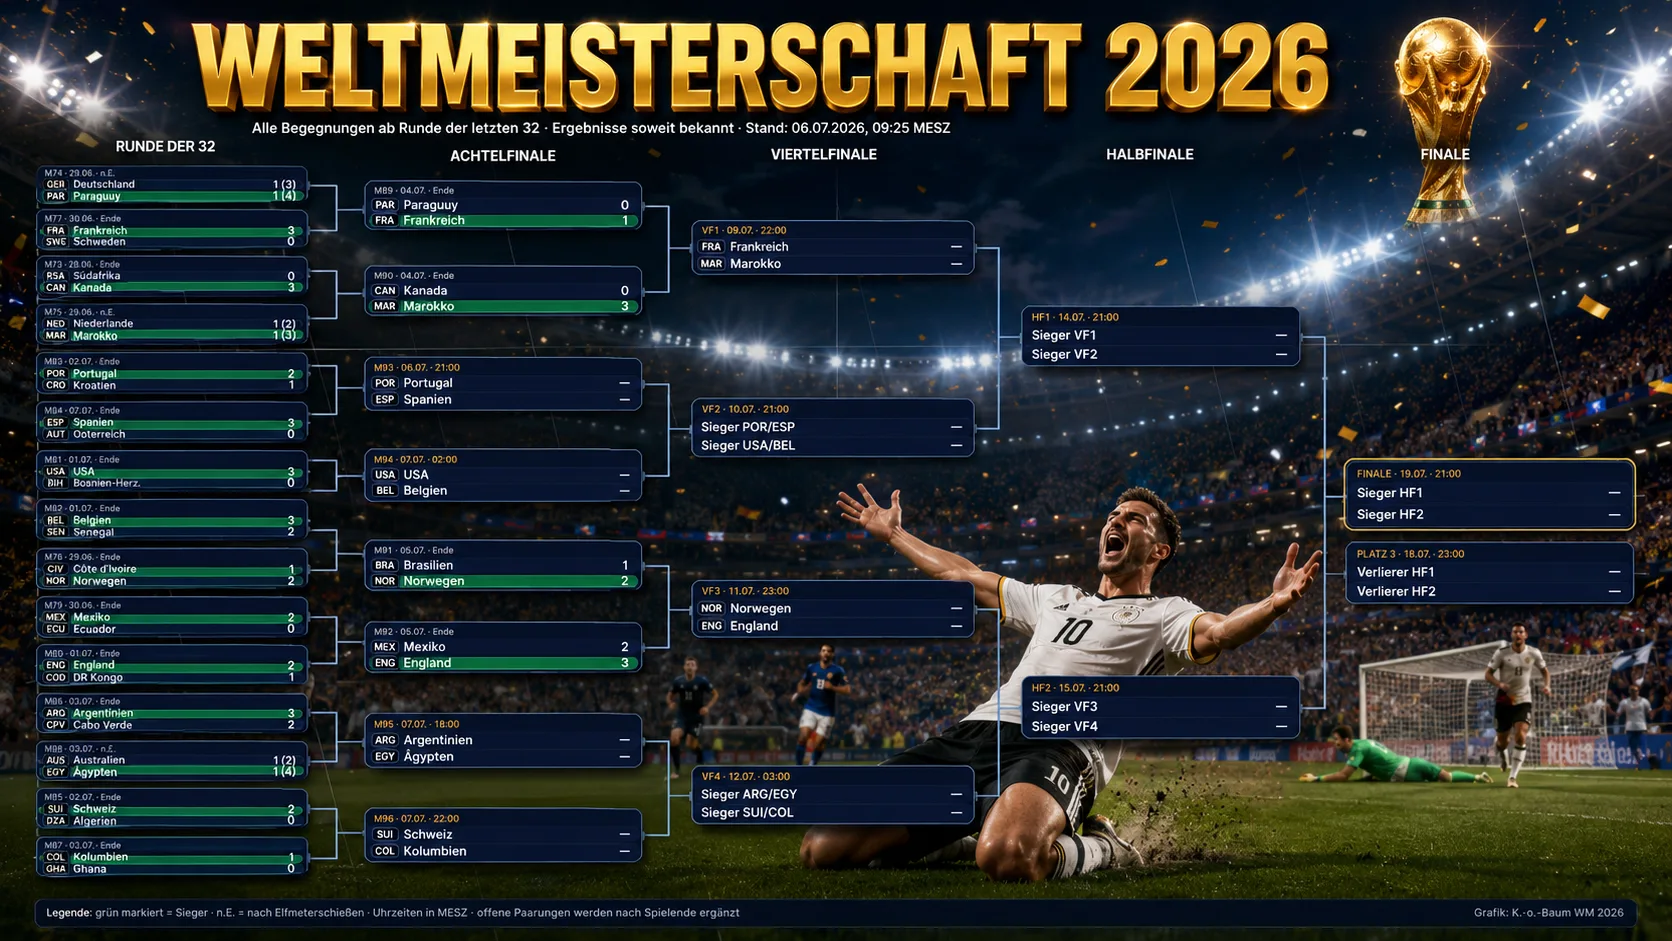
Het WK 2026 heeft de groepsfase achter zich gelaten en is in de knock-outfase beland. Er is veel nieuw: 48 landen, een extra ronde van 32, ongebruikelijke aftraptijden uit Noord-Amerika. Een overzicht van het format, de stand van zaken en de krakers in de achtste finales.