Обновление от 4 сентября 2026 года: OpenAI выпустила GPT-6 Astra. Что приходит в подписку ChatGPT и сколько это стоит — в GPT-6 Astra: доступность и цены.
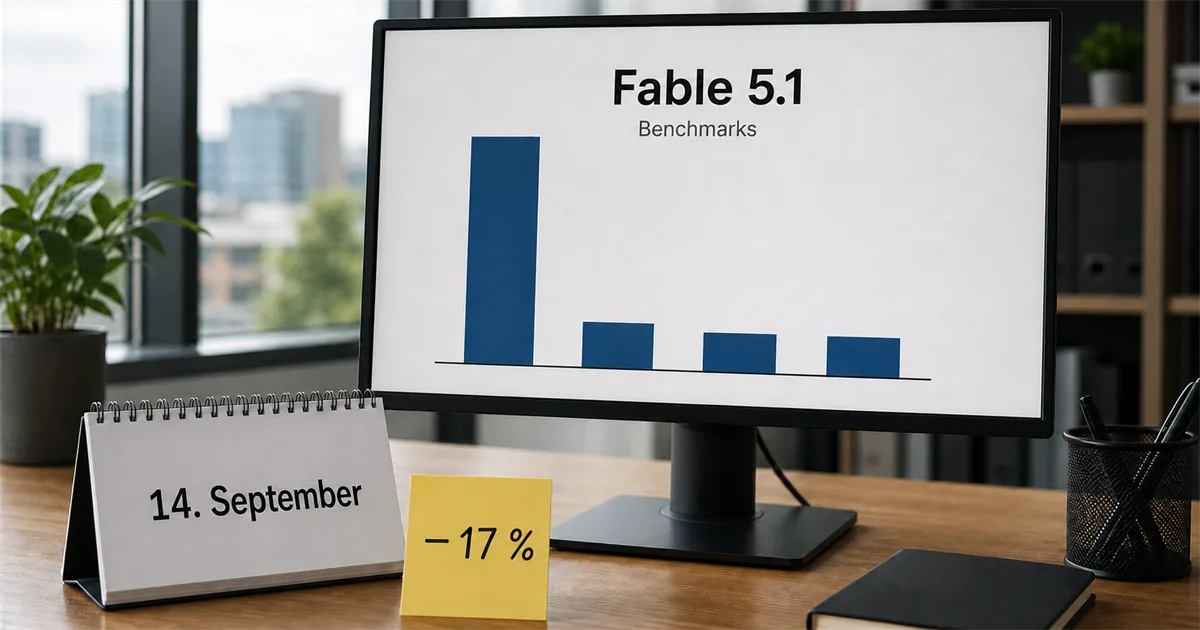
1 сентября 2026 года Anthropic выпустила Claude Fable 5.1. В опубликованных тестах модель решает заметно больше задач, чем её предшественник Fable 5, чем более дешёвый Opus 5 и чем GPT-5.6 Sol от OpenAI – особенно в научных исследованиях и автоматизации бизнес-процессов. Цены за токен не изменились, но Fable 5.1 расходует их меньше: по данным Anthropic, типичные задачи обходятся примерно на 25 процентов дешевле. Однако есть подвох, и в анонсе его нет: с 14 сентября у подписчиков в Claude Code будет фактически примерно на 17 процентов меньше недельной квоты, чем сегодня, – хотя Anthropic преподносит изменение как «на 25 процентов больше использования». Расчёт – ниже.
Содержание
- Что означают проценты в бенчмарках
- Результаты бенчмарков в одной таблице
- Где Fable 5.1 действительно далеко впереди – а где нет
- Сколько стоит Fable 5.1 – и почему «та же цена» всё равно выходит дешевле
- Какая модель для какой задачи? Три рекомендации
- Мелкий шрифт про квоту: анонсировано +25%, на практике −17%
Что означают проценты в бенчмарках
Бенчмарк – это фиксированный набор экзаменационных задач, который все модели получают в одинаковых условиях, как контрольная работа, которую пишут несколько учеников. Процент показывает, сколько задач модель решила. «Terminal-Bench 4.0: 55,8%» означает: Fable 5.1 корректно выполнила 55,8 процента этих тестовых задач.
Три вещи помогают правильно читать цифры:
- 100 процентов не набирает ни одна модель. Задачи намеренно настолько сложны, что даже лучшие системы ошибаются. Поэтому 55 процентов может быть выдающимся результатом – важен отрыв от других моделей, а не абсолютное число.
- Каждый бенчмарк проверяет своё. Модель может быть сильной в тесте по программированию и слабой в научном – как ученик блистает в математике и буксует в английском.
- Одно число в таблице – не процент: GDPval-AA – это рейтинг Эло, как в шахматах. Оценщики сравнивают два ответа и выбирают победителя; из этого складывается рейтинговое число. 1 853 против 1 824 означает: Fable 5.1 выигрывает такие дуэли немного чаще, чем Opus 5.
И одна оговорка, справедливая для любого анонса модели: цифры исходят от самого производителя. Anthropic выбирает, какие тесты попадут в анонс, – вероятно, те, где её модель выглядит хорошо. Независимые перепроверки обычно появляются через дни, а то и недели.
Результаты бенчмарков в одной таблице
Все цифры – из анонса Anthropic от 1 сентября 2026 года. Лучшее значение выделено жирным.
| Бенчмарк (что проверяет) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (задачи научных исследований) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (самостоятельная работа в командной строке) | 55,8% | 42,0% | 52,3% | 37,3% |
| AutomationBench (автоматизация бизнес-процессов) | 31,4% | 17,1% | 26,9% | 19,6% |
| GDPval-AA v2 (офисная и интеллектуальная работа, рейтинг Эло) | 1 853 | 1 723 | 1 824 | 1 711 |
| OSWorld 2.0 strict (управление компьютером как человек: окна, клики) | 41,7% | 36,1% | 39,6% | — |
| Humanity's Last Exam без инструментов (сложные экспертные знания из всех областей) | 60,9% | 57,8% | 56,6% | — |
| CursorBench 3.2.0 (программирование в редакторе кода) | 73,4% | 70,5% | 70,0% | 67,2% |
Где Fable 5.1 действительно далеко впереди – а где нет
Таблица показывает две очень разные картины – в зависимости от того, куда смотреть.
Большие скачки – в двух типах задач. В задачах научных исследований (Terminal-Bench-Science) Fable 5.1 с 52,6 процента решает более чем вдвое больше задач, чем её собственный предшественник, – и оставляет далеко позади Opus 5 (29,0%) и GPT-5.6 Sol (22,4%). Похожая картина в автоматизации бизнес-процессов (AutomationBench): 31,4 процента против 17,1 процента у предшественника. Это ровно те длинные многошаговые задачи, где модель должна самостоятельно планировать, пользоваться инструментами и проверять промежуточные результаты. Anthropic приводит пример из исследований: при проектировании белковых связующих Fable 5.1 достигла доли попаданий почти 50 процентов, тогда как обычными считаются 10–15 процентов.
Небольшим остаётся отрыв в повседневном программировании и знаниях. В тесте редактора CursorBench Fable 5.1 отделяют от предшественника лишь 2,9 процентного пункта, в тесте знаний Humanity's Last Exam – 3,1. Кто использует модель для обычных задач с кодом и текстом, в повседневной работе разницы почти не заметит.
Коротко: Fable 5.1 – это прежде всего модель для длинных самостоятельных цепочек работы: исследований, анализа, многошаговых процессов. Для быстрой разовой задачи преимущество невелико.
Сколько стоит Fable 5.1 – и почему «та же цена» всё равно выходит дешевле
Прейскурантные цены через интерфейс для разработчиков (API) не изменились – экономия в другом:
| Позиция (за 1 млн токенов) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol* |
|---|---|---|---|---|
| Ввод | 10 $ | 10 $ | 5 $ | 4 $ |
| Вывод | 50 $ | 50 $ | 25 $ | 20 $ |
| Кешированный ввод | 0,25 $ | 1,00 $ | — | — |
\* Акционная цена как минимум до 21 ноября 2026 года; прейскурантная цена 5 $/30 $.
Токены – расчётная единица провайдеров ИИ, грубо говоря, фрагмент слова. И здесь настоящий ценовой рычаг: Fable 5.1 расходует меньше токенов на ту же работу. Anthropic оценивает экономию примерно в 25 процентов на типичных задачах и до 45 процентов на длинных самостоятельных цепочках работы. Поставщик финансовых данных Bloomberg сообщает по итогам собственных тестов, что модель была примерно вдвое быстрее Opus 5 и использовала вдвое меньше токенов. К этому добавляется цена кеша: кто многократно отправляет одни и те же документы – обычный случай при длинных рабочих сессиях, – платит за эти повторы лишь четверть прежней цены.
Какая модель для какой задачи? Три рекомендации
Из сочетания цены и результатов тестов следуют три простых правила. Они действительны на сентябрь 2026 года и опираются на приведённые выше данные производителя:
- Повседневные задачи – тексты, письма, переводы, обычное программирование: здесь достаточно среднего класса. Claude Sonnet 5 (2 $/10 $ за миллион токенов) или GPT-5.6 Sol (4 $/20 $) делают эту работу за долю стоимости Fable; на коротких разовых задачах разница в качестве почти не ощущается. Кто работает по подписке Claude, заодно бережёт свою недельную квоту: Fable там «весит» вдвое (см. ниже).
- Сложные разовые задачи – каверзная ошибка в коде, анализ договора, сложная оценка: Claude Opus 5 (5 $/25 $) – оптимум цены и качества. В большинстве тестов он отстаёт от Fable 5.1 лишь на несколько пунктов, но стоит вдвое дешевле.
- Длинные самостоятельные цепочки работы – исследование по многим источникам, многошаговая автоматизация, научный анализ: здесь Fable 5.1 реализует своё преимущество, причём дважды: она решает заметно больше таких задач (52,6% против 29,0% у Opus 5 в научном тесте) и тратит на это меньше токенов. В такой работе более дорогая модель может в итоге оказаться более дешёвой – если считать стоимость выполненной задачи, а не запроса.
Мелкий шрифт про квоту: анонсировано +25%, на практике −17%
Параллельно с анонсом модели Anthropic сообщила об изменении лимитов использования: с 14 сентября 2026 года стандартные недельные лимиты в инструменте программирования Claude Code навсегда вырастают на 25 процентов – для планов Pro, Max, Team и корпоративных мест Enterprise.
Чего в сообщении нет: с мая действует временное повышение на 50 процентов, несколько раз продлевавшееся, которое истекает 13 сентября. Поэтому расчёт выглядит так:
| Недельная квота (база = 100) | |
|---|---|
| Первоначальный лимит | 100 |
| Сегодня (временно +50%) | 150 |
| С 14 сентября (навсегда +25% к старой базе) | 125 |
По сравнению с первоначальным лимитом это действительно на 25 процентов больше. По сравнению с тем, к чему пользователи привыкли за месяцы, – примерно на 17 процентов меньше (125 вместо 150). Оба утверждения верны – просто анонс рассказывает первое и умалчивает второе. Отраслевые издания, такие как BleepingComputer, воспроизвели этот расчёт.
Для моделей Fable в подписках правило не меняется: на местах Max и premium на Fable можно потратить не более половины недельного лимита; дальше – докупать кредиты или переходить на меньшую модель. В плане Pro Fable с самого начала работает только на платных кредитах. То, что Fable 5.1 бережливее расходует токены, на практике это немного смягчает – но сам лимит не меняет.
Если вы прикидываете, какие инструменты ИИ окупятся в вашем деле: как развивались семейства моделей Anthropic и OpenAI, читайте в наших статьях о GPT-5.6 Sol, Terra и Luna и о бурной истории Claude Fable 5. Это руководство выходит на office1.cloud, где самозанятые ведут счета и бухгалтерию.
Prosche rabotat so schetami
Easy Invoice obiedinyaet predlozheniya, scheta i rabotu s klientami v oblake.
Poprobovat Easy InvoiceChitat dalshe
 Новости со всего мира
Программа для футбольного клуба: сайт, приложение и расписание за 39,99 € в месяц
Расписание приходит само, результаты тоже, родители отменяют с телефона, а у клубного турнира есть онлайн-заявка: что программа ligantor снимает с футбольного клуба неделя за неделей – и сколько она стоит.
 Новости со всего мира
Как заработать на Twitch в 2026: монетизация теперь открыта для всех — и что это значит для налогов
Twitch делает монетизацию в 2026 доступной для всех и снижает планку Affiliate. Что это значит для тебя — и когда хобби превращается в налогооблагаемый доход.
 Новости со всего мира
ЧМ-2026: начался плей-офф — в 1/8 финала сошлись гранды
Чемпионат мира 2026 оставил позади групповой этап и вступил в стадию плей-офф. Новшеств много: 48 команд, дополнительный раунд 1/16 финала, непривычное время начала матчей из Северной Америки. Обзор формата, положения дел и топ-матчей 1/8 финала.